Kategoria: Artykuły

  • Kiedy Ala ma kota, a kiedy raka

    Kiedy Ala ma kota, a kiedy raka

    Jednym z najbardziej niezrozumiałych problemów cywilizacyjnych są nowotwory. Każdy nowotwór nazywamy „rakiem”, choć rak jest tylko jednym z wielu rodzajów nowotworów złośliwych (takim wywodzącym się z komórek nabłonkowych). Niejasności zaczynają się już w samym nazewnictwie, więc zacznijmy od podstaw.

    DNA jest jak nieustannie przepisywana biblioteka instrukcji klocków LEGO. Każda komórka naszego ciała, dzieląc się, kopiuje kolejne tomy tej biblioteki. Literami są tutaj nukleotydy, a niezbędnymi do życia zestawami LEGO białka. Przy pisaniu jednego eseju łatwo o pomyłkę, a co dopiero przy miliardach tomów, miliardy razy: przez całe życie.

    Walka z nowotworami i „leki na raka” to tak naprawdę próba naprawienia literówek/mutacji. Aby zrozumieć jak bardzo trudne jest to zdanie, poznajmy jej typy:

    Substytucje

    „AIa ma kota” – mutacja milcząca

    Drugą literą zdania jest tu wielkie „i” zamiast małego „l”. Wygląda identycznie, prawda? Ta drobna zmiana techniczna nie wpływa na sens zdania ani na produkt końcowy. W biologii: Kod genetyczny jest zdegenerowany (ma synonimy). Wiele różnych trójek koduje ten sam aminokwas. Taka mutacja jest milcząca – w kodzie zaszła zmiana, ale białko jest identyczne. Organizm nawet nie zauważa różnicy.

    „Ala na kota” – mutacja zmiany sensu

    Jedna literka zmienia „posiadanie” na „wskakiwanie” lub “atak”. Sens zdania jest poprawny gramatycznie, ale sytuacja staje się kuriozalna lub niebezpieczna. W biologii: To klasyczna mutacja typu missense. Wymiana jednego aminokwasu może sprawić, że białko straci swoją funkcję albo stanie się toksyczne.

    „Ala ma koty” – mutacja korzystna

    Czasem błąd bywa błogosławieństwem. Zmiana jednej litery sprawia, że zamiast jednego kota, mamy ich więcej. W biologii: To rzadkość, ale to właśnie te pomyłki napędzają ewolucję. Jeśli zmutowane białko działa lepiej niż oryginał (np. pozwala trawić laktozę dorosłym ludziom), ta „literówka” rozprzestrzeni się w populacji.

    „Ala ma.” – mutacja nonsensowna

    Wyobraźmy sobie, że w słowie „kota” literę „k” podmieniamy na kropkę. Zdanie urywa się w połowie: „Ala ma.”. Nie wiemy co ma, instrukcja jest niekompletna. W biologii: To stworzenie przedwczesnego sygnału STOP. Białko jest produkowane tylko do połowy i zazwyczaj ląduje w komórkowym śmietniku.

    Insercje i Delecje

    „Aam ak ota” – przesunięcie ramki odczytu

    Jeśli usuniemy jedną literę „L” otrzymamy bełkot. W biologii: To najgroźniejszy rodzaj mutacji. Wszystko, co znajduje się za miejscem błędu, staje się bezużyteczną sieczką aminokwasową. Takie białka często są toksyczne dla komórki.

    „Ala ma kotka” – insercja niepsująca ramki

    Jeśli wstawimy całe słowo zdanie się wydłuża, ale zachowuje sens. W biologii: Białko ma „wstawkę”, dodatkowy fragment. Czasem działa dalej (jak Ala z kotkiem), a czasem ten dodatek blokuje jego działanie.

    „Ala ma Szkota” – zmiana znaczenia

    Wstawienie głoski „Sz” przed „kota” zmienia domowego pupila w mieszkańca Wielkiej Brytanii. W biologii: Nawet jeśli nie zepsujemy ramki odczytu, wstawienie nowego elementu w kluczowym miejscu białka może całkowicie zmienić jego przeznaczenie.

    Duplikacje i Translokacje

    „Ala Ala ma kota” – duplikacje

    Powtórzenie słowa brzmi jak jąkanie. Sens jest zachowany, ale forma jest dziwna. W biologii: Często prowadzi to do nadekspresji genów. Mamy za dużo produktu. W ewolucji to jednak potężne narzędzie – mamy dwie kopie genu: jedna działa normalnie („Ala ma kota”), a druga może bezpiecznie eksperymentować i mutować w coś nowego.

    „Geralt ma kota” – translokacje

    To mój ulubiony przykład absurdu genetycznego. Wyobraźmy sobie, że wyrywamy stronę z „Ani z Zielonego Wzgórza” i wklejamy ją do Wiedźmina. W biologii: Tak powstaje wiele groźnych nowotworów. Gen odpowiedzialny za podziały komórkowe zostaje przeniesiony w miejsce, gdzie jest cały czas aktywny, przez co komórka dzieli się bez opamiętania, bo dostała instrukcję z innej „książki”.

    Kiedy błąd staje się chorobą?

    Wróćmy do naszych dwóch zdań, które wyglądają bliźniaczo podobnie:

    1.​ „AIa ma kota” (wielkie „i” zamiast małego „l”)
    2.​ „Ala ma kota” (poprawne)

    Dlaczego pierwsza mutacja jest neutralna, a inna potrafi zabić? Większość naszego DNA to nie są ścisłe instrukcje budowy białek. To tak zwane regiony niekodujące: marginesy, puste strony, przypisy. Jeśli zrobisz literówkę na marginesie książki („AIa”), treść właściwie się nie zmienia.

    Problem pojawia się, gdy mutacje dotykają kluczowych słowów: np. instrukcji BHP komórki czy hasła do komputera. Zamiast „przestań się dzielić” dostajemy „przestań się lenić”. To jest moment, w którym „Ala” przestaje mieć kota, a zaczyna mieć nowotwór.

    P53 – przykład białka broniącego przed mutacjami obrony przed nowotworami

    Na szczęście nasze komórki wiedzą, że robią błędy. Przykładem molekularneju obrony przed mutacjami jest białko p53, które jest swego rodzaju systemem alarmowym, który porusza się wzdłuż DNA i gdy trafi na „Ala zma kot a…”, to zaczyna krzyczeć i w wyniku pracy innych białek, komórka przestaje się dzielić i naprawia lub popełnia samobójstwo, bo wyrzucić jedną stronę, niż spalić całą bibliotekę.

    A co, jeśli mutacja trafi w sam instrukcję budowy p53? Raczej nie jest zaskakujące, że bez systemu alarmowego ciężej uchronić się przed niebezpieczeństwem. Problem z p53 zdarza się w połowie nowotworów, bo bez nadzoru mutacje przepływają strumieniami. Komórka z uszkodzonym p53 to drukarnia bez kontroli jakości, która powiela bełkot w milionach egzemplarzy.

    Molekularna zupa

    Dlaczego słyszymy o „epidemii raka”? Czy nasze DNA psuje się bardziej niż kiedyś? I tak, i nie.

    Kiedyś ludzie umierali, zanim zdążyli uzbierać krytyczną liczbę literówek. Nowotwór to choroba statystyczna: im więcej razy przepisujesz książkę (im więcej razy Twoje komórki się dzielą), tym większa szansa, że w końcu napiszesz „Szkota” zamiast „kota”. Żyjemy wystarczająco długo, by te błędy się skumulowały.

    Cywilizacja stworzyła nam środowisko pełne mutagenów. Smog, chemia, stres, używki: to wszystko sprawia, że czasami nasz organizm jest jak żeglujący dziennikarz z chorobą lokomocyjną w sztormie. W tej „molekularnej zupie” trudniej o precyzję, a łatwiej o pomyłkę.

    Dlaczego „lek na raka” to medialny mit?

    Często słyszymy w wiadomościach: „Naukowcy odkryli lek na raka!”. Tydzień później temat cichnie. Dlaczego? Wróćmy do naszej analogii.

    • ​U pacjenta A nowotwór powstał, bo w słowie „STOP” zrobiła się literówka.
    • U pacjenta B nowotwór powstał, bo wyrwano stronę z instrukcją „P53”.
    • U pacjenta C nowotwór powstał, bo zdublowano rozdział „ROŚNIJ”.

    Każdy z nich ma „raka”, ale u każdego zepsuło się co innego. Nie da się stworzyć jednej gumki do mazania, która naprawi brak strony, literówkę i dubel jednocześnie. Lek działający na mutację „Ali ze Szkotem” nie zadziała na „Alę bez kota”. Dlatego współczesna onkologia to nie szukanie jednego „magicznego pocisku”, ale precyzyjna korekta tekstu dopasowana do konkretnego błędu w konkretnym wydaniu książki.

    Cena za różnorodność

    Gdyby system kopiowania DNA był idealny i nigdy nie popełniał błędów, pierwsze jednokomórkowce kopiowałby się perfekcyjnie przez miliardy lat, a Ziemia byłaby dziś zamieszkana przez idealną, nudną zupę identycznych bakterii. Nie byłoby ryb, dinozaurów, ani ludzi. Nie byłoby eseju o Ali i jej kocie.

    Mutacje to mechanizm, który pozwala naturze eksperymentować: „A co, jeśli Ala będzie miała płetwy?”. W 99% przypadków taki eksperyment kończy się porażką (chorobą). Ale ten 1% to innowacja, która napędza ewolucję. Rak jest więc tragiczną, ale nieuniknioną ceną, jaką płacimy jako jednostki za to, że jako gatunek jesteśmy skomplikowani, różnorodni i zdolni do rozwoju. To ciemna strona naszej biologicznej kreatywności.

    Podziękowania

    Prof. Ewa Bartnik – zainspirowałą do napisania tego artykułu

    Natalia Bednarek – autorka grafiki

    Źródła

    Brown, T. A. (2023). Genomy. (Wyd. 2025, tłum. P. Węgleński). Wydawnictwo Naukowe PWN, 413-432. Surget, S., Khoury, M. P.,

    Bourdon, J.-C. (2013). Uncovering the role of p53 splice variants in human malignancy: a clinical perspective. OncoTargets and Therapy, 7, ss. 57–68. DOI: 10.2147/OTT.S53876.
  • Czy wirusy mogą zarażać wirusy?

    Czy wirusy mogą zarażać wirusy?

    Wirofagi to jednostki wirusowe, funkcjonujące jako pasożyty obligatoryjne dużych wirusów, gdyż nie są w stanie samodzielnie namnażać się w organizmie gospodarza. Zarażają “wirusy-olbrzymy” i w większości oddziałują z nimi z negatywnym skutkiem, wpływając na replikację, morfogenezę i odporność adaptacyjną. Występują w świeżych wodach śródlądowych, morskich i oceanicznych, glebie, roślinach, zwierzętach i ludziach. 

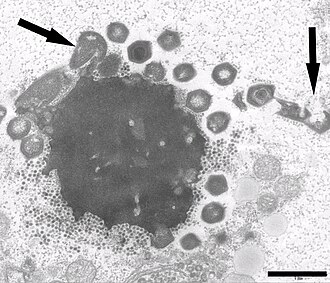
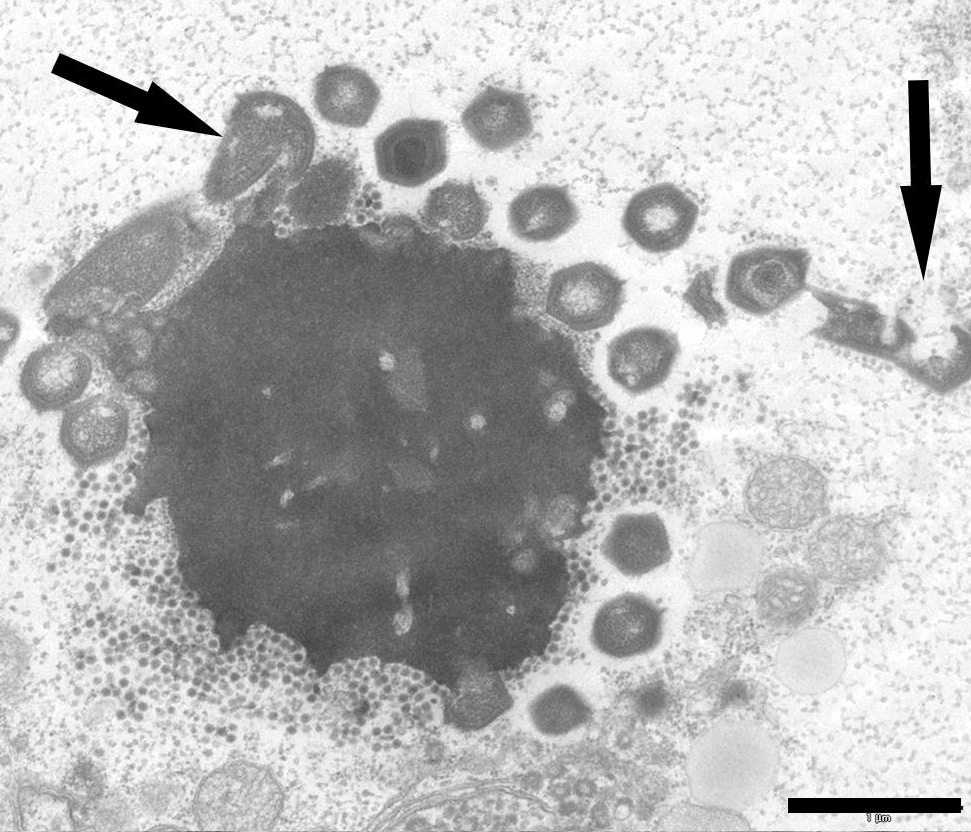
    Dotychczas opisano 37 typów wirofagów. Pierwszy wirofag odkryto w 2008 roku we Francji – za pomocą mikroskopii elektronowej. W cytoplaźmie komórek ameby zakażonych wirusem Acanthamoeba castelinii mamavirus, ujawniono istnienie małego wirusa sateitarnego o średnicy 50 nm. Sputnik (nazwany tak od pierwszego sztucznego satelity Ziemi) okazał się osłabiać zjadliwość Mamawirusa i dlatego został nazwany wirusofagiem, analogicznie do bakteriofaga.  

    Jedynym wirofagiem, który nie wpływa negatywnie na gospodarza, jest Zamilon, którego nazwa z arabskiego oznacza sąsiad.  

    Wirofagi w głównej mierze zbudowane są z głównego białka kapsydu (major capsid protein – MCP). Ich rozmiary wynoszą od 34 do 74 nm (zwykle 50-70 nm) z liniowym lub kołowym DNA. Nie mają membrany. 

    Swoim działaniem zakłócają gigantyczne wirusy, poprzez konkurencyjne wyczerpywanie zasobów gospodarza. Tym sposobem modyfikują ekspresję genów wirusa i zakłócają powstawanie jego “potomstwa”, wspierając w ten sposób przeżywalność komórki gospodarza. W związku z tym wirusofagi uczestniczą w procesach ekologicznych, takich jak kontrolowanie społeczności mikroorganizmów i ułatwianie recyklingu składników odżywczych. 

    https://www.ncbi.nlm.nih.gov/pmc/articles/PMC3991649/figure/pone-0094923-g003/ Cropped from
    Fig 3a in Gaia et al. (2014) Zamilon, a Novel Virophage with Mimiviridae Host Specificity PLoS One 9(4): e94923 Autorzy: Morgan Gaia, Samia Benamar, Mondher Boughalmi, Isabelle Pagnier, Olivier Croce, Philippe Colson, Didier Raoult and Bernard La Scola:

    Proces namnażania się wirofagów rozpoczyna się od ich wniknięcia do komórki gospodarza, co odbywa się na różne sposoby. Drugim etapem jest odwarstwienie – po wniknięciu do komórki gospodarza poprzez endocytozę, wirofag i wirus zostają otoczone pęcherzykami Golgiego. W ten sposób powstaje swoista fabryka wirusów, w której uwalniają swój materiał genetyczny. Do tego procesu przyczynia się niskie pH panujące wewnątrz komórki, które powoduje rozpad płaszczu ochronnego wirusa. W kolejnym kroku tworzone są białka. DNA wirofaga podlega replikacji, transkrypcji i translacji z wykorzystaniem mechanizmu replikacji gospodarza, równolegle z cyklem replikacji wirusa. Na koniec materiał genetyczny jest montowany wewnątrz wirofaga.

    Zdolność wirofagów do zmniejszania patogenności wirusa gospodarza nasuwa myśl o ich potencjalnym zastosowaniu w terapiach chorób wirusowych. Pojawił się pomysł opracowania szczepionek wirusofagowych. W organizmach pacjentów z pozaszpitalnym zapaleniem płuc (PZP) wykryto wirus AMPV, na którym pasożytuje wirusofag Sputnik. Jego inaktywowana forma mogłaby być wykorzystana w profilaktyce PZP. Postuluje się również, że wirusofagi można byłoby modyfikować genetycznie, w celu ich konkurowania z SARS-CoV2.  Innym obszarem, gdzie można byłoby wykorzystać wirofagi, jest terapia celowana, w czym korzystnie działałyby ich niewielki rozmiar i prostota genomu. Wirusofagi mogą stać się też wektorami do insercji genów w inżynierii genetycznej. Mimo dużego potencjału, wdrożenie wirofagów w terapiach nie jest jednak takie proste. Trudności sprawiają ich wysoka specyficzność, wysoka niestabilność poza organizmem gospodarza, ograniczony zasięg żywicieli, ryzyko aktywacji immunologicznej oraz trudności w skalowanej produkcji.

    Poprzez swój specyficzny sposób działania, wirofagi wydają się niezmiernie ciekawym tematem do dalszych badań. Pewne ich cechy dają nadzieję na możliwość wykorzystania ich w przyszłości w zakresie medycyny czy ekologii, na obecnym etapie pozostaje to jednak w obszarze ambitnych celów. Kto wie jednak, co wydarzy się w tym temacie w przyszłości?

  • Znakowanie (bio)cząsteczek w biofizyce molekularnej – jak „zobaczyć niewidzialne”? 

    Znakowanie (bio)cząsteczek jest jednym z fundamentów biofizyki molekularnej – pozwala „zobaczyć” układy, które w swojej naturalnej skali pozostają niewidzialne. Pojedyncze białka czy kwasy nukleinowe mają rozmiary rzędu nanometrów i nie generują wystarczającego kontrastu, by bezpośrednio śledzić ich lokalizację, oddziaływania czy zmiany konformacyjne. Dzięki znakowaniu możliwe jest przekształcenie zdarzeń molekularnych w mierzalne sygnały fizyczne, takie jak zmiana fluorescencji, interferencji czy parametrów spektroskopowych. To z kolei umożliwia ilościowy opis procesów biologicznych – od kinetyki wiązania, przez dynamikę strukturalną, aż po stabilność kompleksów.

    Istnieje wiele strategii znakowania, które różnią się poziomem ingerencji i kontrolą nad miejscem przyłączenia znacznika. Naturalne fluorofory białkowe, takie jak tryptofan, dostarczają informacji o lokalnym środowisku i zmianach konformacyjnych bez konieczności modyfikacji cząsteczki. Z kolei znakowanie genetyczne z wykorzystaniem białek fluorescencyjnych, takich jak Green Fluorescent Protein, pozwala na precyzyjne śledzenie lokalizacji i dynamiki białek w komórkach. Metody oparte na powinowactwie, np. His-tag, umożliwiają kontrolowaną immobilizację i badanie oddziaływań, natomiast znakowanie chemiczne – szczególnie na lizyny z użyciem estrów NHS – oferuje wysoką wydajność kosztem specyficzności i jednorodności próbki.

    Znakowanie odgrywa również kluczową rolę w technikach ilościowych, takich jak bio-layer interferometry (BLI), gdzie umożliwia analizę kinetyki wiązania i wyznaczanie stałych oddziaływań. Wprowadzenie izotopów, np. deuteru, pozwala na zwiększenie rozdzielczości metod takich jak NMR czy manipulację kontrastem w rozpraszaniu neutronów. Z kolei interkalatory DNA, takie jak Bromek etydyny, umożliwiają selektywne wykrywanie kwasów nukleinowych dzięki zmianom właściwości fluorescencyjnych po związaniu. W kontekście badań nad lekami stosuje się zarówno naturalnie fluorescencyjne cząsteczki (np. Doksorubicyna), jak i różne strategie znakowania pozwalające śledzić ich dystrybucję, oddziaływania i los w układach biologicznych.

    Jednocześnie znakowanie nigdy nie jest całkowicie obojętne dla badanego układu. Może prowadzić do zmian struktury, zaburzeń oddziaływań, heterogeniczności próbek czy powstawania artefaktów pomiarowych. W wielu przypadkach obserwowany sygnał jest wypadkową właściwości badanej cząsteczki i samego znacznika. Dlatego kluczowe znaczenie ma świadomy dobór metody znakowania oraz interpretacja wyników z uwzględnieniem jej ograniczeń.

    W tym sensie znakowanie nie jest jedynie techniką pomocniczą, lecz centralnym elementem podejścia biofizycznego – narzędziem, które umożliwia przełożenie złożonych procesów biologicznych na język mierzalnych wielkości fizycznych.

  • Modelowanie molekularne, czyli laboratorium w pudełku

    Modelowanie molekularne, czyli laboratorium w pudełku

    Modelowanie molekularne to technika komputerowa będąca doskonałym uzupełnieniem tradycyjnych metod eksperymentalnych. Klasyczne podejścia do wyznaczenia struktury przestrzennej białek, kwasów nukleinowych i ich kompleksów, takie jak krystalografia rentgenowska, mikroskopia krioelektronowa czy spektroskopia NMR, bywają czasochłonne, bardzo drogie, a niekiedy wręcz niemożliwe do zastosowania dla konkretnego układu. Zastosowanie modelowania komputerowego pozwala oszczędzić czas i koszty, zauważalnie ogranicza liczbę niezbędnych eksperymentów fizycznych oraz daje badaczom pełną kontrolę nad symulowanym układem.

    Metoda ta otwiera przed naukowcami szerokie możliwości – umożliwia wizualizację struktur molekularnych, badanie mechanizmów zwijania białek, analizę dynamiki biomolekuł, a także symulowanie procesów dyfuzji i projektowanie nowych leków. Metody modelowania molekularnego można podzielić na między innymi: mechanikę molekularną (skupiającą się na statycznym obrazie cząsteczki i minimach energetycznych), dynamikę molekularną (ukazująca ewolucję molekuły w czasie), a także dynamicznie rozwijające się techniki uczenia maszynowego, takie jak AlphaFold.

    Współczesna farmacja i medycyna nie mogłyby sprawnie funkcjonować bez wsparcia komputerowego projektowania leków (ang. CADD – Computer-Aided Drug Design). Metody modelowania molekularnego wkraczają na scenę już na etapie wczesnego poszukiwania substancji aktywnych, pozwalając na wirtualne „przesiewanie” (ang. virtual screening) milionów cząsteczek z ogromnych baz danych, bez konieczności ich fizycznej syntezy w laboratorium. W zależności od dostępnych informacji, badacze mogą projektować leki w oparciu o znaną strukturę przestrzenną celu białkowego (tzw. dokowanie molekularne do określonej „kieszeni”) lub na podstawie cech znanych już, skutecznych ligandów. Modelowanie obliczeniowe pozwala oszacować siłę oddziaływań między cząsteczką leku a celem biologicznym, przewidywać właściwości farmakokinetyczne (np. wchłanianie i dystrybucję), a tym samym – wykluczać słabo działające cząsteczki na wczesnym etapie i drastycznie skracać proces wprowadzania nowych, ratujących życie terapii na rynek.

    Dzięki dynamice molekularnej (MD) badacze mogą śledzić fizyczną trajektorię atomów opierając się na wyznaczonych równaniach ruchu w polu siłowym. Narzędzie to służy do obserwacji zmian konformacyjnych i parametrów termodynamicznych w ogromnym zakresie skali czasowej – od pojedynczych femtosekund aż do milisekund. Wymaga to jednak odpowiedniego skonstruowania układu: wyboru odpowiedniego modelu (uproszczonego obrazu rzeczywistości) oraz przygotowania warunków początkowych.

    Wraz z weryfikacją eksperymentalną, modelowanie molekularne jest dziś nieocenionym narzędziem, które pozwala nie tylko badać właściwości fizyczne struktur, ale też odkrywać ich zupełnie nowe funkcje i potencjał terapeutyczny.

    Literatura

    • Pisula, M., Dróżdż, E., Chełmecka, E. (2020). Modelowanie molekularne jako etap poszukiwania nowych substancji o potencjalnym znaczeniu terapeutycznym. Annales Academiae Medicae Silesiensis, 74, 91-98.
    • Ouyang, D., Smith, S. C. (red.) (2015). Computational Pharmaceutics: Application of Molecular Modeling in Drug Delivery. John Wiley & Sons.
    • Lu, C. et al. (2024). Integrated Molecular Modeling and Machine Learning for Drug Design. Journal of Chemical Theory and Computation (ACS Publications).
    • Zdjęcie: Struktura podjednostki alfa syntazy ATP wyznaczona przez AlphaFold (PDB ID: AF_AFP56757F1)